Ist das jetzt irgendwie spannend? Also ist das eine relevante Architekturentscheidung? In Bezug auf die Qualitätsziele würde ich behaupten … … oder Qualitätsszenarien hat das keinen Einfluss. Also das eine wie das andere bekomme ich halt irgendwie genauso verfügbar. Es gibt vielleicht einen kleinen Einfluss, weil ich ja gerne wissen … … weil ja hier die Aussage ist, dass insbesondere der Preis einer folgenden Reparatur … … dass ich den wieder ermitteln kann. Das ist also besonders wichtig. Da habe ich hier den Vorteil, dass ich das irgendwie in irgendeinem dieser Container drin habe. Zum Beispiel in dem Bezahlungscontainer. Und jetzt könnte ich zum Beispiel sagen, der Bezahlungscontainer wird halt redundanter ausgelegt … … in einer höheren Menge an Redundanz als die anderen Container. Also da könnte ich versuchen, dieses Qualitätsziel zum Beispiel eher zu erreichen. Aber es ist jetzt nicht so, dass das hier diese Entscheidung wesentlich beeinflusst … … wie ich meine Qualitätsziele erreiche.
Verteilungssicht
Das Miro-Board zeigt zwei Verteilungen nebeneinander: einen Monolithen auf EC2 (Seite 10) und Microservices in Docker-Containern (Seite 11). Beide bilden dieselben vier Bausteine aus Kapitel 5 ab und binden dieselben externen Systeme an. Eberhard hat Folge 113 mit dieser Sicht begonnen, weil "dieses Zeug auf irgendeine Infrastruktur laufen muss, und diese Infrastruktur hilft mir, das Ziel mit der Verfügbarkeit zu lösen" (14:54).
Die Wahl zwischen Monolith und Microservices ist vertagt (ADR-014, Status Deferred). Eberhard hält sie für die Qualitätsziele für "relativ irrelevant": "Das eine wie das andere bekomme ich genauso verfügbar" (Folge 113, 20:29 bis 21:37). Was beide Varianten seit Folge 113 verbindet: mindestens zwei Instanzen über mehrere Availability Zones (ADR-015), weil der AWS-SLA einen Ausfall erst zählt, wenn mehr als eine Availability Zone ausfällt (32:30 bis 33:39). Die Board-Seite 10 mit "einer EC2-Instanz" hält den Stand vor dieser SLA-Analyse fest; die Diagramme unten zeigen den Stand danach.
Transkript Folge 113, 20:29 bis 21:37
Transkript Folge 113, 32:30 bis 33:39
Das steht dort drin, das ist ein juristischer Text, das steht drin. Ein Ausfall bedeutet, dass mehr als eine Availability Zone in der Region ausgefallen ist. Was sind Regions und Availability Zones? Regions sind sowas wie EU West 1 gibt es zum Beispiel, das ist irgendwie Frankfurt, wenn ich mich recht entsinne. Und die Availability Zones sind Rechenzentren. Das heißt also, in Frankfurt gibt es jetzt mehr Rechenzentren, das sind die Availability Zones. Also so ungefähr, genau genommen ist nur die Aussage, die fallen unabhängig voneinander aus. Das heißt, die Aussage, die Amazon trifft, ist, du musst darauf vorbereitet sein, dass eine Availability Zone ausfällt. Erst wenn mehr als eine Availability Zone ausfällt, dann gilt das überhaupt als ein Ausfall unseres Systems. Das heißt also mit anderen Worten, was wir jetzt auf jeden Fall machen müssen, ist, wir müssen irgendwie unser System verteilen auf mehrere Availability Zones. EKS, der Kubernetes Cluster, macht das offensichtlich automatisch. Da müsste ich dann nur dafür sorgen, dass ich mehrere Container Instanzen laufen habe. Bei EC2 müsste ich so eine Elastic Load Balancer davor stecken und dafür sorgen, dass ich mindestens zwei EC2 Instanzen dementsprechend habe.
Infrastruktur Ebene 1
Beide Varianten teilen den Rahmen. Nutzer:innen greifen über den Webbrowser zu (Board Seite 10: "Rechner nutzen das System über den Webbrowser"). Der Webshop bindet das Reparatur-System per Links und Umleitung von /reparatur an (ADR-002). Alle anderen externen Systeme sind über REST angebunden: Kasse, Online Payment Service, Rechnungswesen, SMS Versand, EMail System (Board Seite 3 und 10).
Variante A: Monolith auf EC2-Instanzen
Alle vier Bausteine laufen als ein Deployment-Artefakt auf EC2 bei AWS (Board Seite 10). Das Board zeichnet eine Instanz; das Transkript verlangt für 99 % mindestens zwei Instanzen hinter einem Elastic Load Balancer über mehrere Availability Zones (Folge 113, 33:35 bis 34:38; ADR-015). Die Datenbank ist RDS (ADR-016).
Transkript Folge 113, 33:35 bis 34:38
Da müsste ich dann nur dafür sorgen, dass ich mehrere Container Instanzen laufen habe. Bei EC2 müsste ich so eine Elastic Load Balancer davor stecken und dafür sorgen, dass ich mindestens zwei EC2 Instanzen dementsprechend habe. Das ist also jetzt etwas sehr Konkretes, was sich ableitet aus unserer Verfügbarkeitsanforderung. Wenn ich also ernsthaft einigermaßen verfügbar sein will, muss ich in der Amazon Cloud diese Voraussetzung treffen und Verfügbarkeit ist ein relevantes Thema. Und ich würde, daraus würde ich also jetzt für mich ableiten, dass ich mindestens diese Voraussetzung schaffen muss. Und das ist jetzt eben etwas, was, denke ich, hilfreich ist. Also nochmal irgendwie darauf zu schauen, was da eigentlich genau steht. So, jetzt ist das nächste Thema. Genau, was steht da noch weiter? Also für eine EC2 Instanz garantieren Sie 90% Verfügbarkeit pro Stunde. Nicht-Verfügbarkeit bedeutet keine Konnektivität.
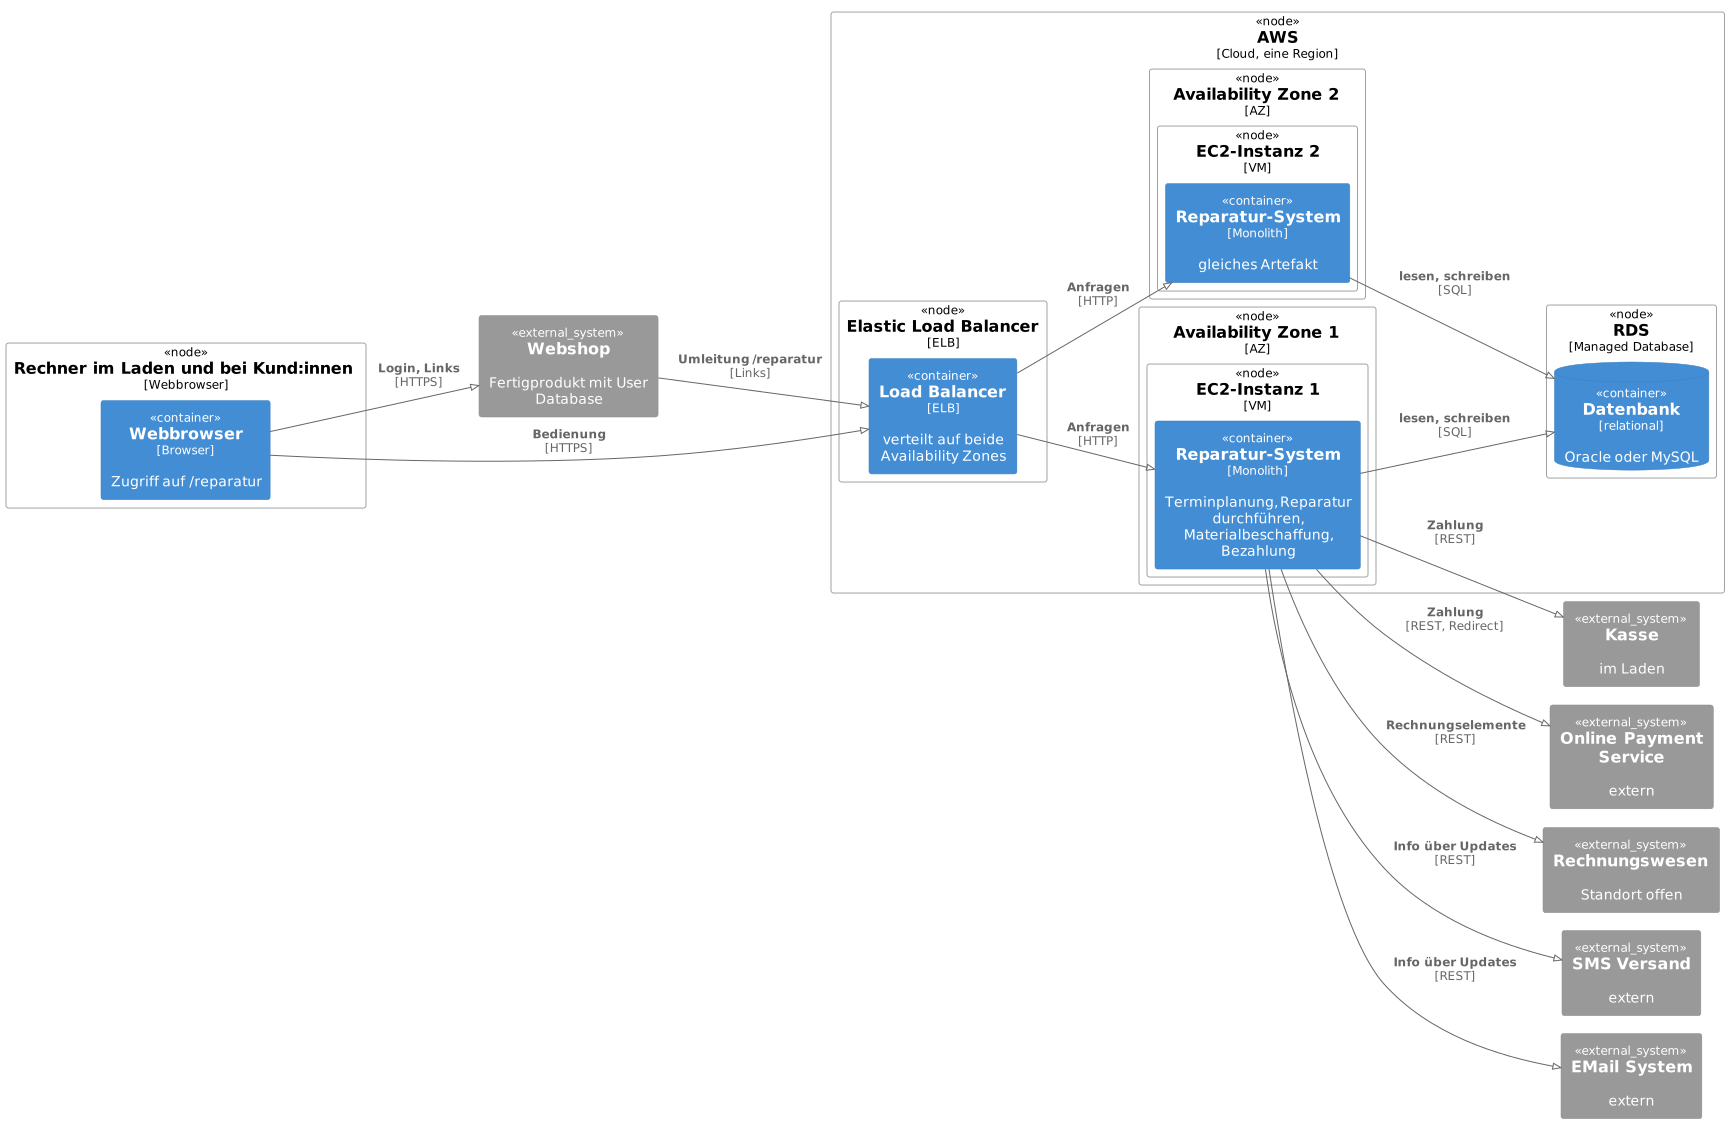
- Zuordnung von Bausteinen zu Infrastruktur
-
Terminplanung, Reparatur durchführen, Materialbeschaffung und Bezahlung laufen in einem Prozess je EC2-Instanz; beide Instanzen tragen dasselbe Artefakt, der Elastic Load Balancer verteilt die Anfragen. Die Aufrufe "Termin", "Preis" und "Materialbestellung" aus Kapitel 5 bleiben prozessintern. Die Aufrufe nach außen gehen von jeder Instanz aus; das Diagramm zeichnet sie nur an Instanz 1.
- Begründung
-
Das Board nennt keine. Die Variante ist die einfachere von beiden: ein Artefakt, kein Netz zwischen den Bausteinen. Die zweite Instanz und der Load Balancer folgen aus dem AWS-SLA: EC2 braucht "ELB plus zwei Instanzen" (Folge 113, 33:35; ADR-015).
Variante B: Microservices in Docker-Containern
Jeder Baustein läuft in einem eigenen Container aus einem eigenen Docker Image (Board Seite 11). Die Informationsflüsse sind dieselben wie in Variante A, laufen aber über das Netz. Seit Folge 113 gilt: Der EKS-Cluster verteilt die Container "offensichtlich automatisch" über mehrere Availability Zones (33:25 bis 33:39; ADR-015); der Container Bezahlung könnte höher redundant laufen, "fünf Instanzen, die anderen nur zwei" (22:20).
Transkript Folge 113, 33:25 bis 33:39
Das heißt also mit anderen Worten, was wir jetzt auf jeden Fall machen müssen, ist, wir müssen irgendwie unser System verteilen auf mehrere Availability Zones. EKS, der Kubernetes Cluster, macht das offensichtlich automatisch. Da müsste ich dann nur dafür sorgen, dass ich mehrere Container Instanzen laufen habe. Bei EC2 müsste ich so eine Elastic Load Balancer davor stecken und dafür sorgen, dass ich mindestens zwei EC2 Instanzen dementsprechend habe.
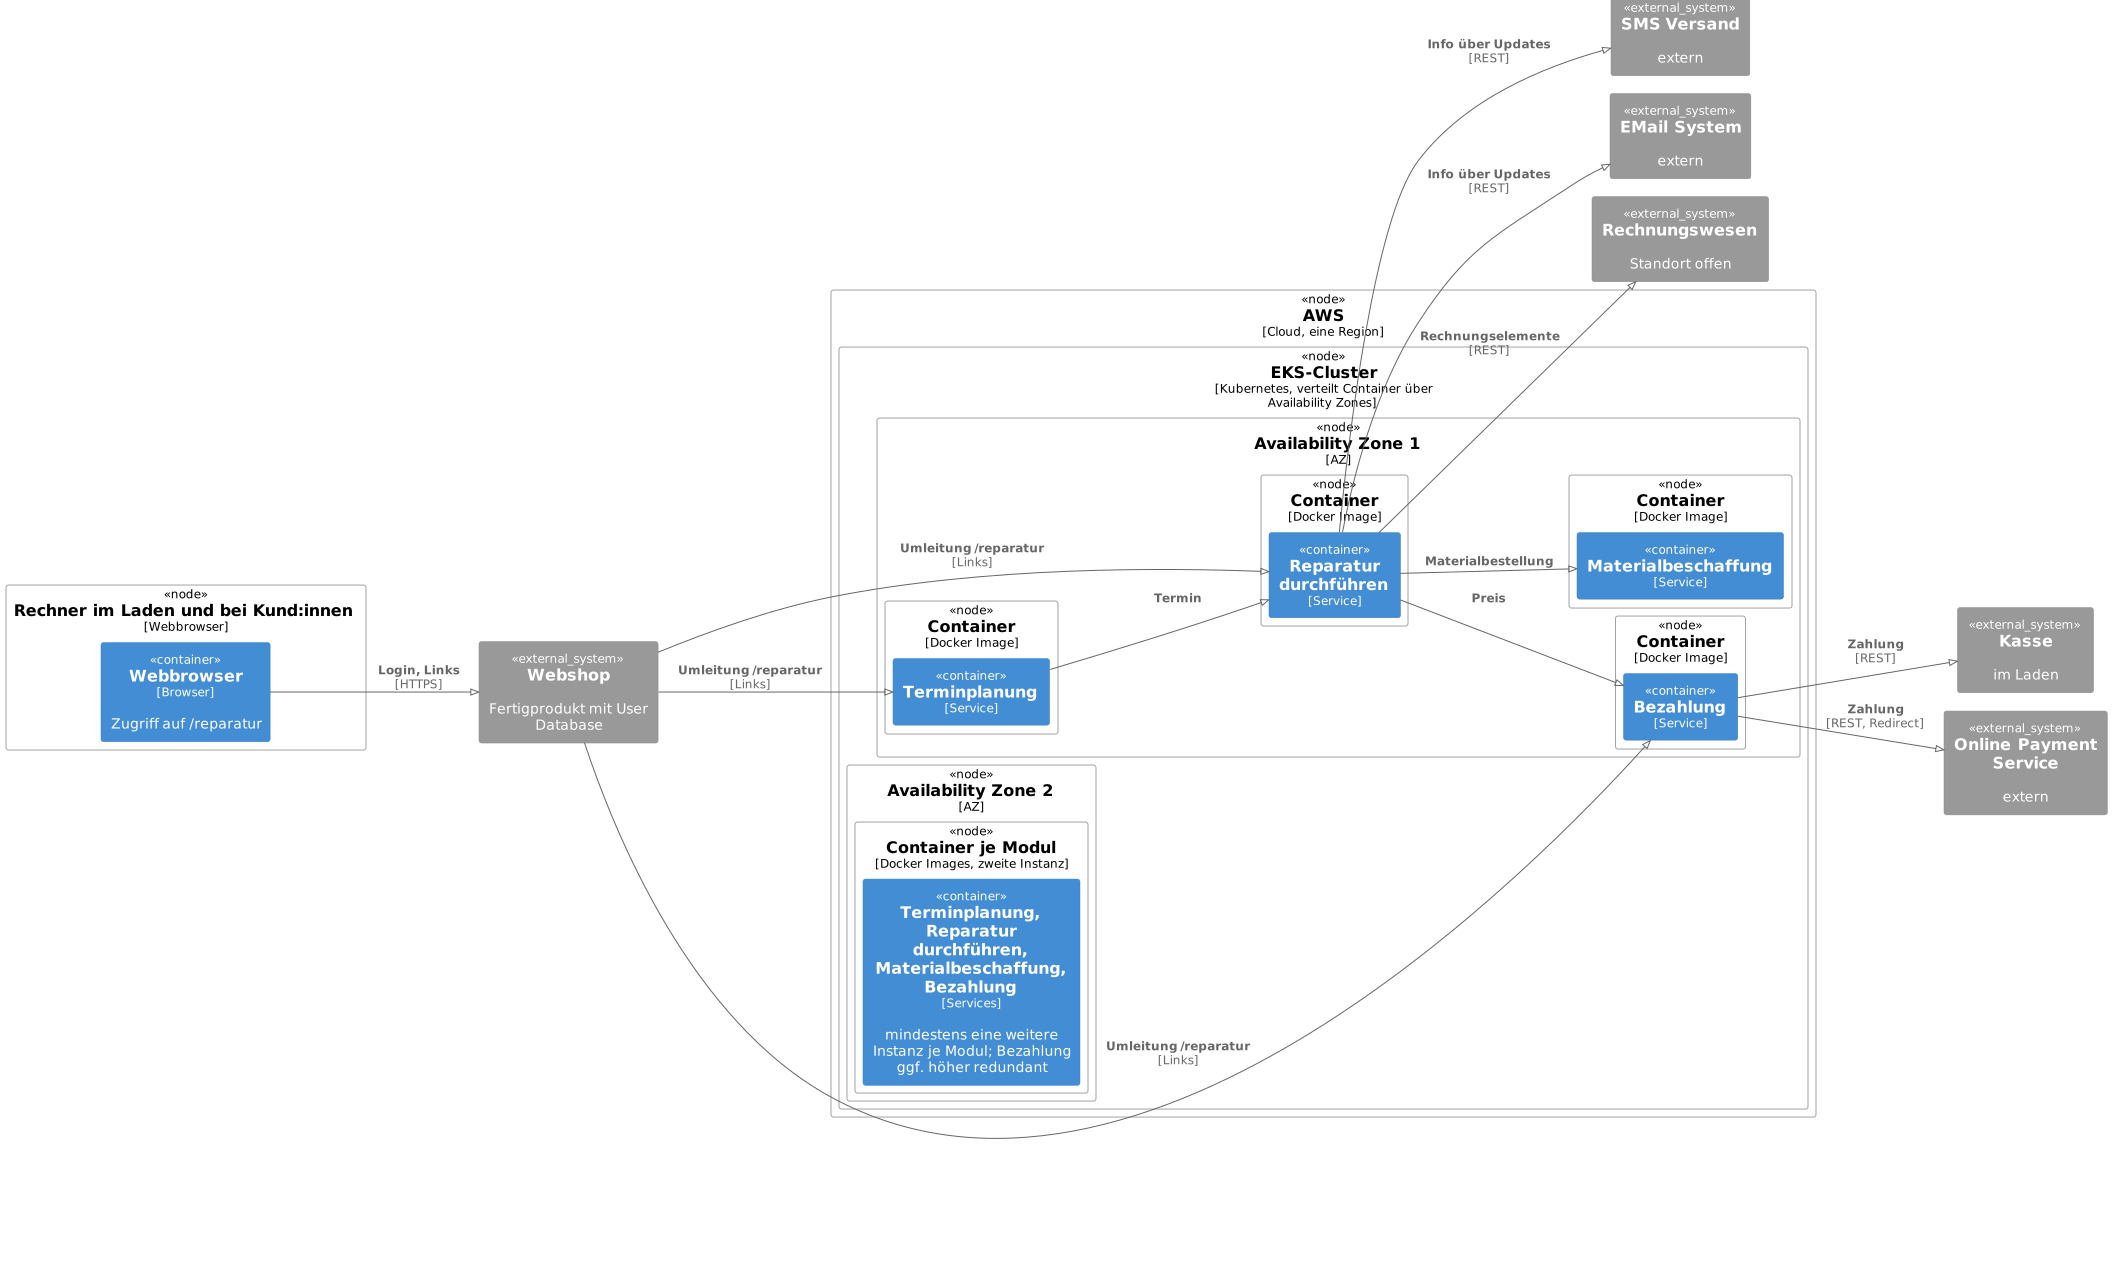
- Zuordnung von Bausteinen zu Infrastruktur
-
Ein Container je Baustein, mindestens zweimal über die Availability Zones verteilt. Die Aufrufe "Termin", "Preis" und "Materialbestellung" werden zu Netzaufrufen zwischen Containern. Das Diagramm zeichnet die Aufrufe nur an den Containern in Zone 1.
- Begründung
-
Das Board nennt keine. Die Maßnahmen-Karte "EKS / EC2 SLAs" (Board Seite 6) nennt EKS, den Kubernetes-Dienst von AWS, "oder irgendwas, was Container abbilden kann" (Folge 113, 17:40). Eberhard sieht einen kleinen Vorteil: Bezahlung als eigener Container kann redundanter laufen; das hilft gegen Ausfall, nicht beim Wiederanlauf, "was das wesentliche Kriterium ist" (22:31 bis 22:45). Jan im Chat: Die Latenz zwischen Containern ist gegenüber der Latenz Laden zu Rechenzentrum zweitrangig (21:50).
|
Note
|
Offen: Protokoll zwischen den Containern und Reverse Proxy fehlen auf dem Board. Die Datenbank ist RDS (ADR-016), die Datenhaltung je Service ist nicht entschieden; das Diagramm lässt sie deshalb weg. |
Vergleich der Varianten anhand der Qualitätsziele
Die Qualitätsziele aus Kapitel 1 setzen die Rangfolge: Benutzerfreundlichkeit, Änderbarkeit Richtung SaaS, Verfügbarkeit. Die Tabelle bewertet die Varianten nur dort, wo Board oder ADRs einen Beleg liefern. Zellen mit ? brauchen ein Urteil des Teams.
| Qualitätsziel | Variante A: Monolith | Variante B: Microservices |
|---|---|---|
Benutzerfreundlichkeit |
? Für Kund:innen und Werkstatt ist die Verteilung unsichtbar; das Board gibt keinen Unterschied her. |
? Wie A. Ein Einfluss auf die Zwei-Minuten-Beauftragung (Board Seite 5) ist nicht belegt. |
Änderbarkeit Richtung SaaS |
? Das Änderungsszenario (Board Seite 6) nennt Cloud, Mandantenfähigkeit und Skalierbarkeit als Maßnahmen, keine Verteilung. |
? Wie A. Ob getrennte Container die Mandantenfähigkeit erleichtern, ist nicht belegt. |
Verfügbarkeit |
Mindestens zwei Instanzen hinter einem Elastic Load Balancer über mehrere Availability Zones (ADR-015). Wiederanlauf in 30 Minuten (Werkstatt) und 99,9 % im Web (ADR-008) hängen am AWS-SLA, der einen Ausfall erst ab mehr als einer Availability Zone zählt (Folge 113, 32:30). |
Container je Modul, von EKS über Availability Zones verteilt (ADR-015). Ein Ausfall trifft einen Baustein, nicht alle; Bezahlung kann höher redundant laufen. Eberhard: Das hilft gegen Ausfall, nicht beim Wiederanlauf (22:31 bis 22:45); beide Varianten sind "genauso verfügbar" (20:38). |
Betrieb ohne IT-Experten (Randbedingung, Board Seite 5) |
Ein Artefakt, zwei gleiche Instanzen. Weniger bewegliche Teile. |
? Kubernetes-Betrieb ohne IT-Experten ist nur mit eigenem Support (ADR-017) denkbar. |
Infrastruktur-Annahmen
Die Maßnahmen-Karten der Qualitätsszenarien (Board Seite 5 und 6) waren Annahmen an die Infrastruktur. Folge 113 hat sie geprüft und entschieden:
-
Cloud. Antwort auf "Im Shop sind keine IT-Experten beschäftigt. Das System kann dennoch betrieben werden." und auf das SaaS-Änderungsszenario. Entschieden in Folge 113 (ADR-013): kein Server im Laden, weil niemand ihn betreiben und in 30 Minuten wieder anfahren könnte (06:01, 09:14); eigenes oder externes Rechenzentrum teurer und nicht verfügbarer (38:04 bis 38:15). AWS aus Vertrautheit, Google "wäre auch fein" (53:12).
-
EKS / EC2 SLAs. Antwort auf alle Verfügbarkeitsszenarien: 99 % Werkstatt 9 bis 18 Uhr, 99,9 % Web 7 bis 24 Uhr, Wiederanlauf in 30 und 2 Minuten (ADR-008; die Karte "5 Minuten" ist im Video nicht belegt, Kapitel 10). Konkretisiert in Folge 113 (ADR-015): mindestens zwei Instanzen über mehrere Availability Zones. Bei SLA-Verletzung gibt es nur eine Dienstgutschrift, der Schaden bleibt beim Betreiber (35:03 bis 35:26); ein Ausfall der ganzen Region ist "hinreichend unwahrscheinlich", Ausweichen in eine andere Region ist nicht geplant (32:38 bis 36:53).
-
RDS SLAs? Antwort auf "Daten, die älter als 5 Minuten sind, stehen mit 99,9 % Sicherheit wieder zur Verfügung." Entschieden als relationale Datenbank, Oracle oder MySQL, kein NoSQL (ADR-016, 41:24 bis 41:39). Das Fragezeichen bleibt: RDS garantiert Verfügbarkeit, "den Datenverlust aber nicht getrennt" (42:01).
-
Eigener Support, nachts Eigener Support 24/7. Antwort auf den Betrieb ohne IT-Experten und auf das nächtliche Web-Ziel. Entschieden (ADR-017): für die Ladenzeiten eine Entwicklerin, für das Web-System Rufbereitschaft rund um die Uhr (40:16 bis 40:59).
-
Mobiler LTE/5G-Router als Reserve im Laden. Nicht auf dem Board. Antwort auf Jans Frage nach dem Routerausfall (08:24 bis 14:13): Das Netzrisiko im Laden ist ein akzeptiertes Risiko, das mit dem Kunden zu besprechen ist; der mobile Router ist die günstige Reserve, ein Cache-Server im Laden ist verworfen (ADR-018).
Zwei offene Fragen stehen auf beiden Deployment-Seiten des Boards (Seite 10 und 11):
-
"Kann man aus der Cloud in das Rechnungswesen kommunizieren?"
-
"Kann man aus der Cloud in die Kasse kommunizieren?" (R-010 aus ADR-004)
Folge 113 behandelt beide Fragen, entscheidet sie nicht und benennt sie als Risiko (24:38 bis 27:23, 29:27). Eberhard erkennt sie erst beim Ausführen des Deployment-Diagramms: "ich habe potenziell etwas, was mir meinen Ansatz kaputt machen kann" (26:14), "das kann mir im Extremfall die Lösungsstrategie zerstören" (26:57). Genannte Optionen: direkt REST aus der Cloud, weil "Kassensysteme heutzutage im Prinzip auch PCs" sind; ein Kassenproxy im Laden (Vorschlag von Zuschauer Jan, 29:27, "eine mögliche Lösung"); ein Server im Laden; eine Änderung am Kassensystem (27:07). Online Payment ist nicht betroffen (24:10); die Frage gilt für beide Varianten gleich (26:34 bis 26:50). R-022 aus ADR-008 hält fest, dass das Web-Ziel 99,9 % und die lokale Integration in verschiedene Richtungen ziehen.
Transkript Folge 113, 24:38 bis 27:23
Das heißt, das kriegt man halt auch irgendwie hin. Und was ich jetzt hier identifiziert habe als ein Thema, ist … … ich hätte hier eine Kommunikation aus der Cloud hin zu der Kasse, die bei mir im Laden steht. Und da wäre halt … ich benutze mal irgendwie gelb … … eine Frage, kann man aus der Cloud in das Rechnungswesen kommunizieren? Und die analoge Frage wäre jetzt bei der Kasse. Also da wäre halt dieselbe Frage, kann man aus der Cloud in die Kasse kommunizieren? Und ich will das gar nicht ausschließen. Also was ich ja konkret machen müsste, wäre … … der Mensch sitzt halt an meinem System, sagt, diese Rechnung, das Ding will ich jetzt irgendwie gerne bezahlen. Und daraufhin gibt es eine Kommunikation hin zur Kasse, die sagt, ich möchte jetzt gerne das 20 Euro kassiert werden … … und die das halt irgendwie auch vernünftig in die Buchhaltung bekommt und so weiter und so weiter. Und dazu müsste ich halt mit diesem Kassensystem reden, aus der Cloud. Und vielleicht ist das möglich. Also das wäre jetzt die Stelle, wo man es halt recherchieren müsste. Kassensysteme sind heutzutage im Prinzip auch PCs, sodass ich das nicht ausschließen möchte, dass das geht. Aber das wäre etwas, was wir diskutieren müssten. Und das ist jetzt tatsächlich etwas, was wir sozusagen gelernt haben. Also was ich persönlich auch bei der Vorbereitung gelernt habe, als ich eben dieses Diagramm ausgeführt habe. Das heißt, das hat mir jetzt tatsächlich etwas geholfen. Also ich habe jetzt herausgefunden, dass ich hier potenziell etwas habe, was mir meinen Ansatz kaputt machen kann. Und das ist, glaube ich, die spannendere Sache. Die würde jetzt hier unten an der Luke gelten. Also, Moment. Jetzt habe ich bedauerlicherweise die Bausteine sich dafür torpediert. Also das wäre hier eben bei dem Microservices genau das selbe Thema. Da müsste ich also exakt dieselbe Frage beantworten. Das heißt, ich kann diese beiden Post-its da auch mal rüber kopieren, weil das wäre hier auch ein Thema. Das heißt, ich habe jetzt ein Risiko identifiziert und das ist auf jeden Fall hilfreich. Das kann mir im Extremfall die Lösungsstrategie zerstören. Ich kann nicht mit der Kasse kommunizieren. Ich kann nicht mit dem Rechnungswesen kommunizieren. Dann habe ich halt irgendwie ein Problem und da muss ich vielleicht doch ein Server installieren. Oder irgendwas auf dem Kassensystem machen oder was auch immer. Das ist dann eben das, womit ich mich da beschäftigen muss.
Transkript Folge 113, 26:34 bis 26:50
Jetzt habe ich bedauerlicherweise die Bausteine sich dafür torpediert. Also das wäre hier eben bei dem Microservices genau das selbe Thema. Da müsste ich also exakt dieselbe Frage beantworten. Das heißt, ich kann diese beiden Post-its da auch mal rüber kopieren, weil das wäre hier auch ein Thema.
Infrastruktur Ebene 2
|
Note
|
Offen: Das Board zeigt keine Ebene 2. Bekannt seit Folge 113: Elastic Load Balancer vor mindestens zwei Instanzen in zwei Availability Zones (ADR-015), RDS als relationale Datenbank (ADR-016). Nicht beschrieben: Netze, Reverse Proxy und Umgebungen (Entwicklung, Test, Produktion). |
Folge 113 auf software-architektur.tv und Video auf YouTube. Die Zeitmarken im Text springen im Player an die Stelle. Audio: software-architektur.tv (Eberhard Wolff, Ralf D. Müller), Lizenz CC BY 4.0; für genaues Springen mit konstanter Bitrate neu kodiert.
Feedback
Was this page helpful?
Glad to hear it! Please tell us how we can improve.
Sorry to hear that. Please tell us how we can improve.